Sí, es posible aumentar la probabilidad de que ChatGPT recomiende tu marca uniendo tres cosas: acceso técnico para los rastreadores de IA, señales de entidad verificables y contenido escrito en pasajes autocontenidos y citables. Lo primero que debe hacer cualquier equipo de marketing es abrir la puerta a los crawlers de IA, redactar dos o tres pasajes citables en sus páginas más importantes y comprobar que su marca aparece correctamente enlazada en fuentes externas mediante sameAs. A partir de ahí, la métrica que hay que vigilar cada mes es la tasa de citación (Citation Rate) frente a la competencia directa.
Hoja de ruta rápida: qué hacer en los primeros 30 días
El posicionamiento en ChatGPT no depende de un único truco, sino de ejecutar en paralelo tareas técnicas, editoriales y de reputación externa. Antes de invertir tiempo en contenido nuevo, conviene ordenar el trabajo en un calendario de cuatro semanas con responsables claros.
- Semana 1, revisión técnica: comprueba el archivo
robots.txtpara verificar que no bloquea a GPTBot ni a otros rastreadores de IA, y revisa los registros del servidor para confirmar que esos bots ya están accediendo al sitio. - Semana 1, llms.txt: crea un archivo
llms.txten la raíz del dominio con un resumen estructurado de las páginas clave, siguiendo el Llmstxt. - Semana 2, indexación: activa IndexNow si tu proveedor de hosting o CMS lo permite, para notificar cambios de URL a los motores compatibles sin esperar al rastreo natural.
- Semana 2 y 3, contenido: redacta entre dos y tres pasajes citables por página prioritaria (definiciones cortas, datos verificables, listas numeradas) y añade el esquema
FAQPage. - Semana 3 y 4, reputación externa: cierra al menos dos menciones en prensa especializada o directorios sectoriales y revisa que los perfiles oficiales de la marca estén enlazados entre sí.
Este orden importa: sin acceso técnico, ningún pasaje citable sirve de nada porque el rastreador nunca llega a leerlo.
Acceso e indexación por crawlers de IA: robots, llms.txt e IndexNow
Antes de escribir una sola línea de contenido optimizado, hay que confirmar que los sistemas de recuperación pueden acceder a la web. Esto es SEO técnico puro, pero con destinatarios distintos a los de Google.
GPTBot, PerplexityBot y otros rastreadores de IA respetan las reglas de robots.txt, igual que Googlebot. Si el archivo bloquea agentes desconocidos por defecto, esos sistemas nunca verán el contenido, sin importar lo bien escrito que esté. Conviene revisar los logs del servidor durante una semana para confirmar visitas reales de estos user agents antes de asumir que todo funciona.
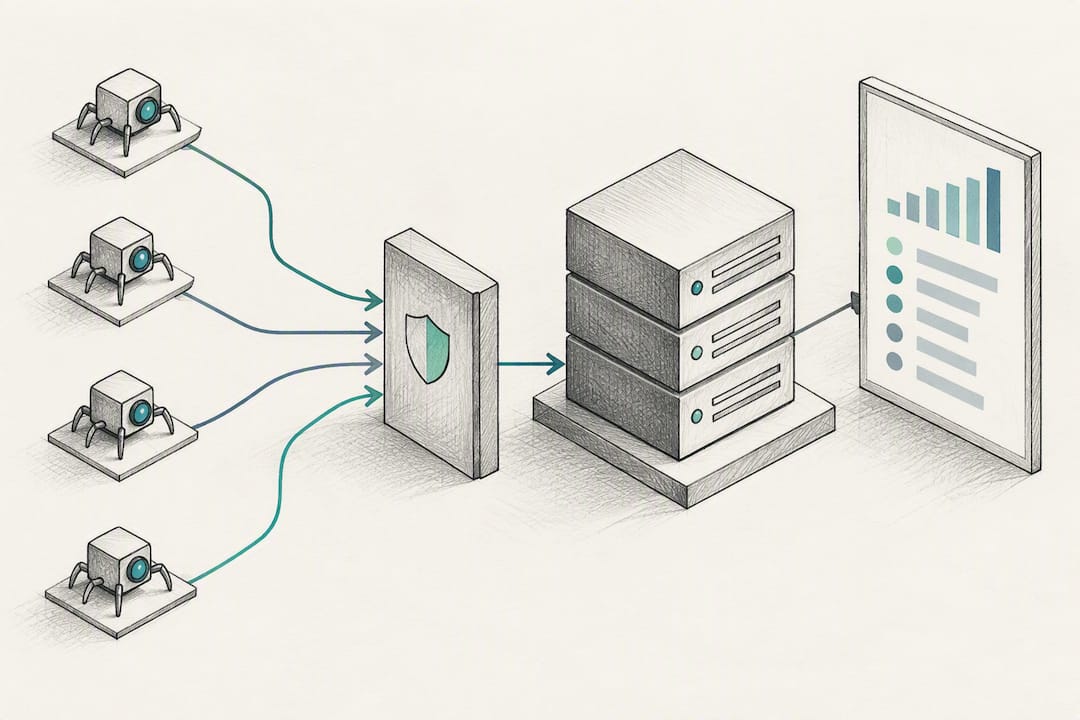
El archivo llms.txt es un estándar comunitario, no una directiva oficial de ningún proveedor grande. Sirve para resumir en texto plano y estructurado qué contenido de un dominio es relevante y dónde encontrarlo, siguiendo la propuesta de llmstxt.org. En WordPress existen plugins como website-llms-txt que generan el archivo automáticamente a partir de las páginas publicadas. Su valor práctico es limitado hoy: ningún modelo mayoritario lo ha adoptado como fuente única de rastreo, así que funciona como complemento, no como sustituto del resto del trabajo técnico.
IndexNow acelera el descubrimiento de URLs nuevas o modificadas en los motores que lo soportan, lo que resulta útil cuando publicas o actualizas pasajes citables y quieres que entren cuanto antes en los sistemas de recuperación que alimentan respuestas generativas, según explica la propia documentación de IndexNow. En WordPress puede activarse con el plugin oficial de IndexNow sin tocar código.
- Revisa que el contenido crítico no dependa de JavaScript para renderizarse; muchos rastreadores de IA no ejecutan scripts como lo haría un navegador.
- Sirve una versión HTML completa del contenido principal, incluso si usas un framework de renderizado en cliente.
- Evita paywalls agresivos o interstitials que impidan leer el texto en la primera carga.
Consejo profesional: revisa los logs del servidor filtrando por «GPTBot» y «PerplexityBot» al menos una vez al mes. Un aumento súbito de visitas de estos agentes suele preceder a un repunte en las citaciones, y detectarlo pronto te permite reforzar esas páginas con más pasajes extraíbles.
Qué datos estructurados priorizar para que la IA extraiga tu contenido
No todos los tipos de schema aportan lo mismo a la visibilidad en modelos de lenguaje. Con recursos limitados, hay un orden de prioridad que funciona bien para la mayoría de webs B2B:
- Organization con
sameAs: enlaza los perfiles oficiales de LinkedIn, prensa y directorios sectoriales para consolidar la identidad de la marca como una entidad única. - FAQPage: marca las preguntas y respuestas reales de tus páginas de servicio; es uno de los formatos que los sistemas de recuperación aprovechan mejor por su estructura pregunta/respuesta.
- BlogPosting o Article: identifica autor, fecha de publicación y fecha de actualización, campos que ayudan a establecer frescura y autoría.
- Service: útil si vendes servicios concretos con alcance y precio definidos, porque describe la oferta en un formato que los motores entienden sin ambigüedad.
El formato recomendado para implementar todo esto es JSON-LD, tal como detalla la documentación de Json-ld. Los campos críticos que no deberían faltar nunca son el autor, la fecha, el campo sameAs de la organización y el mainEntity cuando se trata de una FAQ. Schema.org mantiene la referencia oficial de tipos como BlogPosting, que conviene consultar antes de improvisar propiedades.
El marcado no garantiza una citación directa en ChatGPT, pero ayuda de forma indirecta: mejora cómo Google y Bing entienden e indexan tus páginas, y esos mismos índices alimentan buena parte de los sistemas de recuperación (RAG) que los modelos generativos consultan al construir una respuesta. Si tu CMS es WordPress, plugins de SEO habituales ya generan buena parte de este JSON-LD sin necesidad de programar desde cero.
Cómo escribir pasajes citables, definiciones y FAQs
Un pasaje citable tiene tres rasgos que casi nunca fallan: se entiende sin necesidad de leer el párrafo anterior, cabe en dos o tres frases, y contiene un dato o afirmación verificable. Los sistemas de recuperación no citan artículos completos, citan fragmentos, así que cada bloque de texto debe funcionar como una unidad independiente.
- Escribe la definición antes de la explicación. Si el lector busca «qué es GEO», la primera frase debe responderlo sin rodeos; el desarrollo y los matices van después.
- Usa listas numeradas para procesos. Los pasos ordenados son de los formatos que más fácilmente se extraen y reutilizan en una respuesta generativa.
- Añade tablas de referencia cuando compares opciones. Una tabla con columnas claras se lee y cita con más precisión que un párrafo narrativo denso.
- Cierra cada sección con una FAQ breve. Tres o cuatro preguntas con respuestas de dos frases cubren las variantes de búsqueda que no aparecen en el cuerpo del texto.
Fragmentar la información en bloques autocontenidos con metadatos claros es precisamente lo que necesita un sistema de recuperación aumentada por generación (RAG) para atribuir correctamente una fuente, según explica el análisis de Citora sobre qué es GEO. Esto significa escribir pensando en el fragmento, no solo en el artículo completo: cada H2 y H3 debería poder sostenerse por sí mismo si se extrae fuera de contexto.
Una plantilla que funciona bien en páginas de servicio B2B es la combinación de una definición corta al inicio, seguida de una tabla comparativa de características y cerrada con tres preguntas frecuentes con datos concretos.
Consejo profesional: escribe primero la respuesta de la FAQ como si fuera un tuit de una sola frase. Si necesitas más de 280 caracteres para responder, la pregunta probablemente esconde dos preguntas distintas y conviene dividirla.
Construir la entidad de marca: sameAs, Wikidata, PR y grounding
La visibilidad en modelos de lenguaje depende más de la autoridad multicanal que de ajustes técnicos aislados. Un sitio con schema perfecto pero sin menciones externas ni presencia consistente en otras fuentes rara vez aparece como recomendación en una respuesta generativa.
El concepto clave aquí es la coherencia de la entidad: que tu marca aparezca con el mismo nombre, descripción y enlaces en todas las plataformas donde tiene presencia oficial. Wikipedia y Wikidata funcionan como señales de entidad que algunos modelos usan para verificar quién es quién, según recoge la entrada de Wikipedia sobre optimización de modelos de lenguaje. Conseguir una entrada propia en Wikipedia solo tiene sentido cuando la marca ya cumple sus criterios de notoriedad; forzarla antes de tiempo suele acabar en un borrado.
- Enlaza el campo
sameAsde tu Organization a LinkedIn, prensa relevante, directorios del sector y cualquier perfil oficial verificado. - Revisa que el nombre de la empresa se escriba igual en todas las fuentes externas, sin variantes ni abreviaturas inconsistentes.
- Prioriza menciones en medios especializados del sector industrial por encima de notas de prensa genéricas de bajo valor.
- Fija un objetivo trimestral medible, por ejemplo tres menciones nuevas en prensa sectorial o un directorio relevante por trimestre.
Cómo medir la visibilidad en ChatGPT y otros modelos
Antes de invertir más presupuesto en GEO conviene tener claro qué se mide y cómo. Tres métricas cubren la mayoría de necesidades:
- Share of Voice: proporción de veces que tu marca aparece citada frente a la competencia directa, para un conjunto representativo de prompts del sector.
- Citation Rate: porcentaje de respuestas generativas relevantes en las que tu marca aparece mencionada o enlazada como fuente.
- Brand Mentions: menciones directas del nombre de la marca, con o sin enlace, dentro de las respuestas de los modelos consultados.
Comparar la evolución del Share of Voice por modelo y por prompt es la forma operativa de saber si las acciones de GEO están funcionando; sin monitorización periódica no hay aprendizaje reproducible, según señala el análisis de BIGSEO sobre SEO para IA.
Para recopilar estos datos, define un panel fijo de 20 o 30 prompts representativos de tu sector y ejecútalos manualmente cada mes en ChatGPT, Perplexity y Gemini, anotando si tu marca aparece y en qué posición. Complementa esto con la segmentación de tráfico entrante desde asistentes de IA en Google Analytics 4, filtrando por fuente de referencia. El uso de asistentes conversacionales sigue creciendo: cerca de un tercio de los adultos estadounidenses ya ha usado ChatGPT, casi el doble que dos años antes, según datos de Pew Research. Cuando la citación sube, refuerza esas páginas con más enlaces internos y actualízalas antes; cuando baja, revisa primero si un competidor ha publicado contenido más reciente sobre el mismo tema.
Cómo usar ChatGPT en el propio flujo de trabajo GEO
ChatGPT no solo es el destino de esta estrategia, también es una herramienta útil para construirla. El ciclo que funciona en la práctica tiene cuatro pasos y conviene no saltarse ninguno.
- Generar borrador de pasaje citable: pide un resumen de 40 a 60 palabras que responda directamente una pregunta concreta del sector, sin introducción ni relleno.
- Verificar cada dato contra una fuente real: ningún dato generado por un modelo se publica sin comprobar su origen; los modelos generativos pueden inventar cifras con total naturalidad.
- Marcar el pasaje con schema: una vez validado el texto, añade el
FAQPageoBlogPostingcorrespondiente antes de publicar. - Monitorizar tras publicar: incluye la nueva página en el panel de prompts de seguimiento para detectar si empieza a citarse en las semanas siguientes.
Este proceso evita el mayor riesgo de usar IA para SEO: publicar afirmaciones que suenan bien pero que ningún humano ha comprobado. La trazabilidad de fuentes no es opcional, es lo que separa un pasaje citable útil de uno que puede dañar la credibilidad de la marca.
Cómo aplica ARTIC el SEO para IA en clientes industriales B2B
El SEO para IA suele trabajarse con un método basado en planificación trimestral con objetivos medibles, ejecutada en sprints quincenales junto al cliente y con un responsable de cuenta dedicado al seguimiento, para evitar que la parte de GEO quede aislada del resto de la estrategia digital.
En un proyecto de SEO para IA B2B, las comprobaciones iniciales suelen incluir auditorías técnicas de acceso de crawlers de IA, revisión del contenido citables y evaluación de la coherencia de la entidad en los canales oficiales.
Los plazos razonables para ver movimiento en citaciones suelen medirse en meses, no en semanas, porque dependen de que los modelos actualicen sus fuentes de grounding y de que la autoridad de marca se consolide en múltiples canales a la vez.
Cómo puede ayudarte ARTIC a posicionarte en ChatGPT
Muchas agencias integran las tres capas (acceso técnico, entidad y contenido citable) dentro de un único plan trimestral con KPIs claros, en lugar de tratarlas como proyectos independientes que nadie termina de conectar entre sí.
La primera auditoría de SEO para IA de ARTIC revisa el acceso de crawlers, la cobertura de schema y el estado actual de la entidad de marca en canales externos, y entrega un diagnóstico con prioridades concretas para las primeras semanas. A partir de ahí, el trabajo se ejecuta en sprints quincenales con reporting periódico, igual que el resto de servicios de la agencia, desde el desarrollo web hasta la consultoría digital o las automatizaciones con inteligencia artificial que pueden apoyar la publicación y monitorización continua de pasajes citables.
Si tu empresa industrial necesita saber en qué punto está frente a ChatGPT y sus competidores, el primer paso es solicitar una auditoría inicial y revisar juntos qué palancas moverán antes la aguja: acceso técnico, entidad de marca o contenido extraíble.
Fuentes
Preguntas frecuentes
¿Cómo se hace SEO para IA en la práctica?
Se combina acceso técnico para crawlers de IA (robots.txt, llms.txt), datos estructurados con JSON-LD y contenido escrito en pasajes autocontenidos y verificables. Sin las tres capas a la vez, los resultados suelen ser limitados porque cada una depende de las otras.
¿Cuáles son los mejores prompts para trabajar contenido con ChatGPT?
Los prompts más útiles piden respuestas cortas y verificables: «resume esto en un texto breve respondiendo directamente la pregunta» o «genera tres preguntas frecuentes con respuestas de dos frases sobre este tema». El paso siguiente, siempre, es comprobar cada dato antes de publicarlo.
¿Cuáles son los cuatro pilares del SEO?
Suelen citarse como técnico, contenido, autoridad (enlaces y menciones) y experiencia de usuario. En el contexto de SEO para IA, estos mismos pilares se traducen en acceso de crawlers, pasajes citables, señales de entidad y rendimiento de la página.
¿Cómo se consigue posicionarse en ChatGPT?
Aparecer en ChatGPT depende de que el modelo tenga acceso a fuentes fiables sobre tu marca durante su fase de recuperación de información, no de una técnica de posicionamiento tradicional. Reforzar la entidad de marca, publicar pasajes citables y mantener presencia consistente en canales externos son las palancas que más influyen hoy.
¿Cuánto cuesta un proyecto de SEO para IA con ARTIC?
Los detalles actualizados de los servicios de SEO para IA B2B están disponibles solicitando una auditoría inicial.
